「Markdownはもうオワコンらしい」。 最近、SNSでこんな話が流れてきませんでしたか?
発信元は「AnthropicのClaude Codeチームのエンジニア」とのこと。 AIの最前線にいる人の発言となれば、気になるのも当然です。 僕もこのブログの記事をすべてMarkdownで書いているので、正直ドキッとしました笑
でも、ちょっとだけ立ち止まってみてください。 この記事は、Markdownで書かれています。 そしてあなたは今、それをHTML(Webページを表示するための言語)として読んでいます。
「MarkdownとHTML、どちらが勝つのか」。 その答えは、実はもう目の前にあります💡
結論——変わったのは、AI→人間
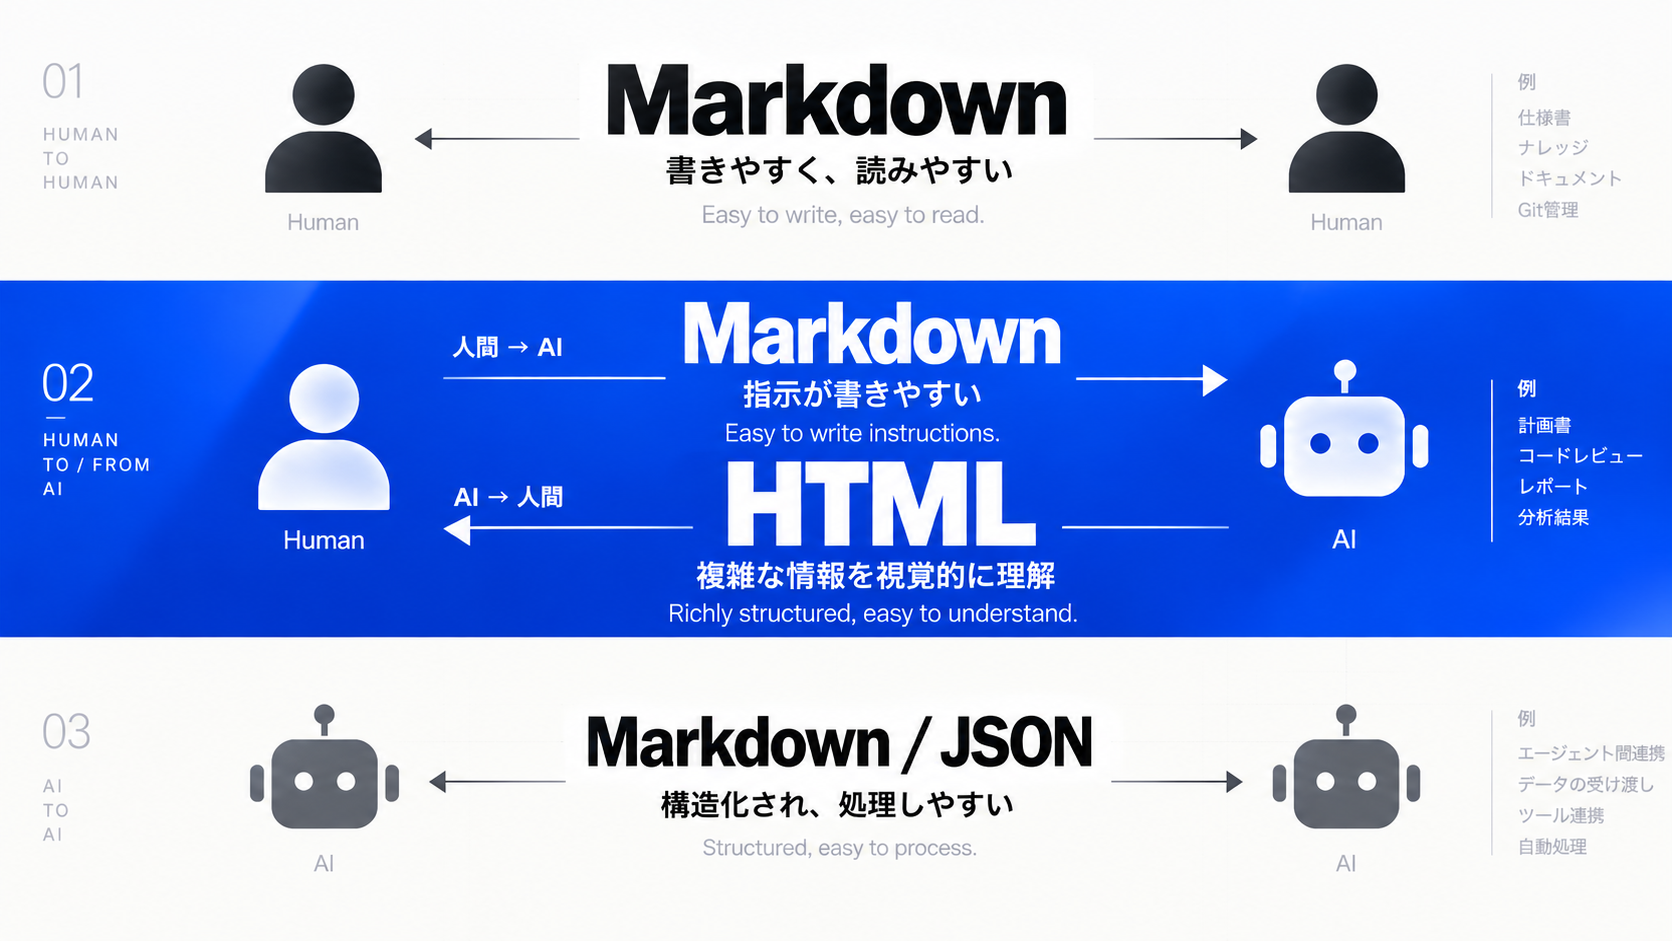
文章は、「書き手」と「読み手」の2つ立場に分けられます。そして、文章を扱う存在として「人間」「AI」の2役が存在し、3つの組み合わせが存在します。
関係 | 向きと具体例 | 最適な形式 |
|---|---|---|
人間 ⇄ 人間 | 仕様書、ナレッジ、Git管理する文書 | Markdown |
人間 ⇄ AI | 人間 → AI:プロンプト、指示書 | Markdown |
〃 | AI → 人間:計画書、コードレビュー、レポート | **HTML(ここだけ変わった)** |
AI ⇄ AI | エージェント同士の受け渡し | Markdown / JSON |
そして、.mdではなHTMLが最適だと言及されたのは、「AIが書いて、人間が読む」場合に関してのみです。
決して、.mdが死んだ訳ではありません。
.mdの使われる場所が、1つ減っただけに過ぎません。
では、なぜそれが「Markdownの死」として広まったのか。
ここから原文をたどってみます。
原文は何と言っていたのか——「dead」はどこから来たのか
経緯——X長文記事から公式ブログへ
発端は2026年5月8日(日本時間では9日)、Xに投稿された1本の長文記事です。 書いたのは、AnthropicでClaude Codeの開発に携わるエンジニア、Thariq Shihipar氏。 タイトルは『Using Claude Code: The Unreasonable Effectiveness of HTML』でした。
同時にスレッドへ添えられたのが、「HTML is the new markdown」という一言です。 その後、5月19日には同じ内容がClaudeの公式ブログにも掲載されています。
原文の主張——Markdownへの敬意から始まる
主張そのものはシンプルです。 エージェント(自律的に作業を進めるAI)は、長い計画やレビューを出力するようになりました。 それを人間が読む場面では、HTMLのほうが情報を豊かに表現できる、という話です。
表、図、色分け、さらにはボタンやスライダーまで、1つのファイルに収められます。 ここで見落とされがちなのが、原文の書き出しです。 Thariq氏は、Markdownのシンプルさや持ち運びやすさをきちんと認めた上で、話を始めています。
「dead」という言葉は、原文のどこにも出てきません。
本人が書いた「本当の理由」
公式ブログ版には、もう一つ見逃せない記述があります。 Thariq氏がHTMLを使う本当の理由は、Claudeとの作業の「ループの中に留まるため」でした。
Claudeに任せる仕事が増えるにつれ、自分が計画をじっくり読まなくなっていた。 Claudeの判断に関わり続けたい。その手段として選んだのがHTMLだった、という話です。
つまり、原文の核は「フォーマットの優劣」ではありません。 「人間がAIの仕事から目を離してしまう問題」への、一つの処方箋なのです。
さらにThariq氏は、「常にHTMLで返す」設定を急いで作る必要はない、とも助言しています。 Markdownを葬るどころか、本人がブレーキを踏んでいるわけです。
嘘をついたのは誰か
タイトルで「嘘」と書きましたが、Thariq氏は嘘をついていません。 原文にあるのは「HTML is the new markdown」という比喩だけです。
では、「dead」はどこから来たのでしょうか? 答えは、拡散の途中です。
タイムラインでは、「便利になった」より「〇〇が終わった」のほうが指が止まります。 二次記事の見出しには、「Markdownを殺した」という言葉まで登場しました。
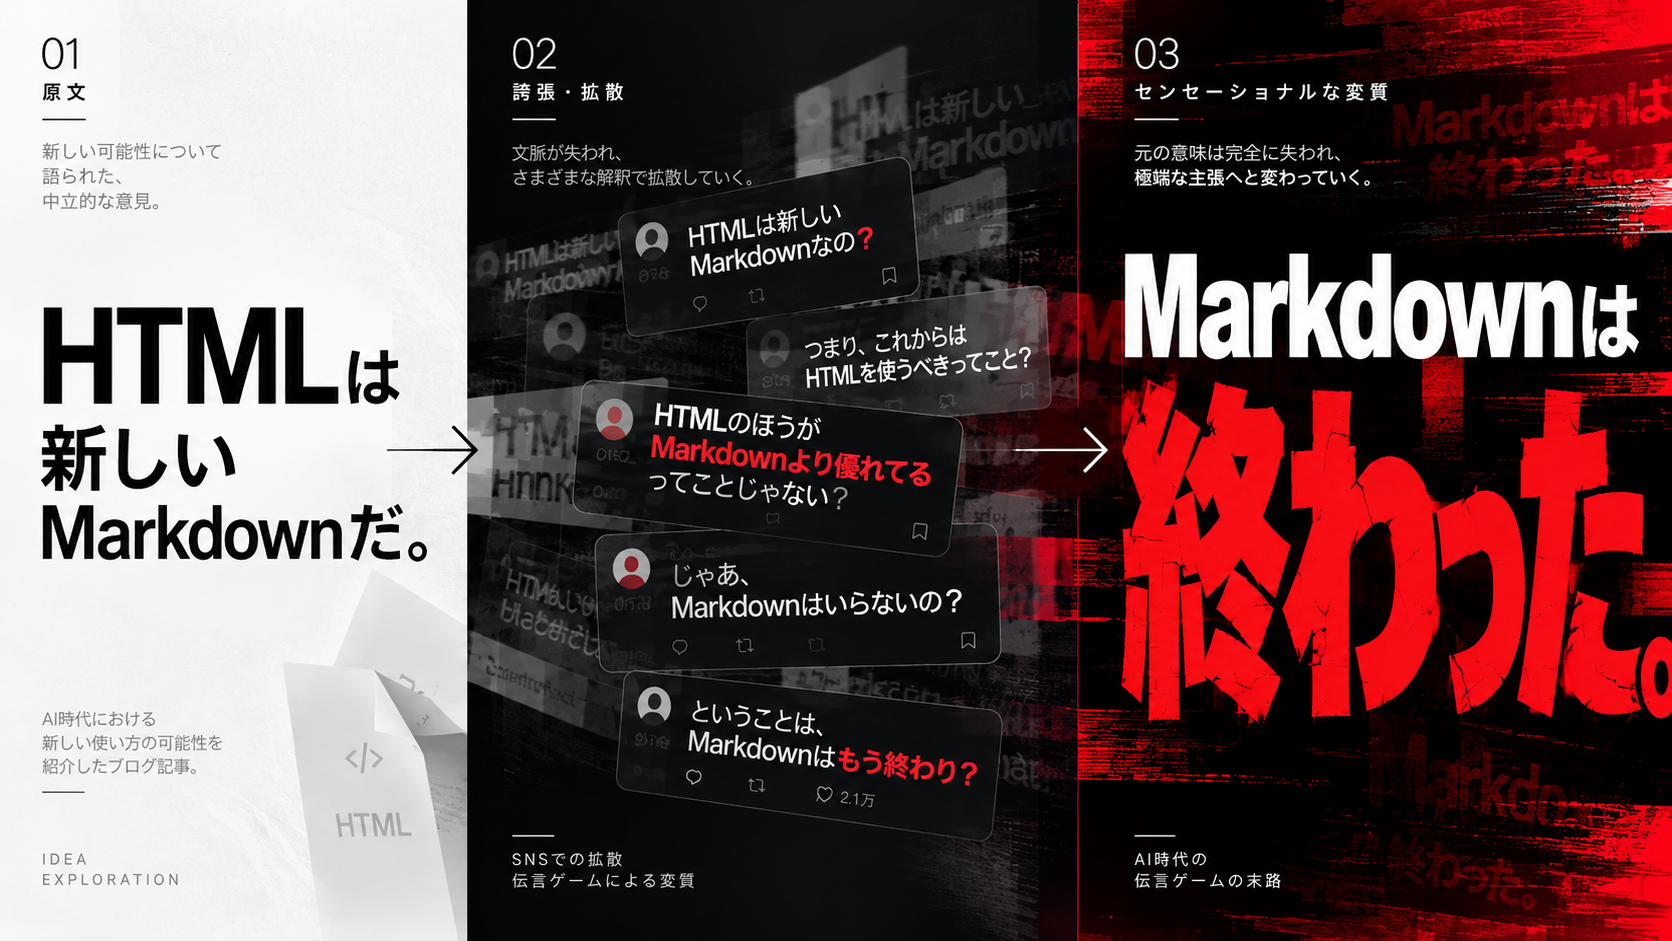
一人ひとりの意図までは分かりません。 ただ、強い言葉ほど拡散される構造が、比喩を死亡宣告に変えたのは確かです。 嘘をついたのは原文ではなく、伝言ゲームの構造です。
認知科学には、スコトーマ(心理的な盲点)という言葉があります。 強い見出しに意識を奪われると、その裏にある「なぜ」が見えなくなる。 「dead」という一語が、まさにそのスコトーマを作っていました。
……そして僕もいま、同じ構造を使ってタイトルに「嘘」と書きました笑
あなたがここまで読んでいるなら、その効果はすでに証明されています。
今日から使える、3つの使い分け
ここからは実践編です。 上記を踏まえ、明日からの作業にどう落とし込むかをまとめます。
① 長くなりそうな出力は「HTMLで」と頼む
100行を超えそうな計画書やレビューは、最初からHTMLで出してもらいます。 指示はこれだけで十分です。
この内容を、1ファイルで完結するHTMLにまとめてください。
表・図・色分けを使い、全体像がひと目でわかる構成にしてください。
できたファイルは、ブラウザで開くだけで読めます。 縦に長い文章をスクロールし続けるより、全体の見通しが一気に良くなります。
② 「使い捨てUI」を作ってもらう
HTMLの真価は、読むだけで終わらないところにあります。
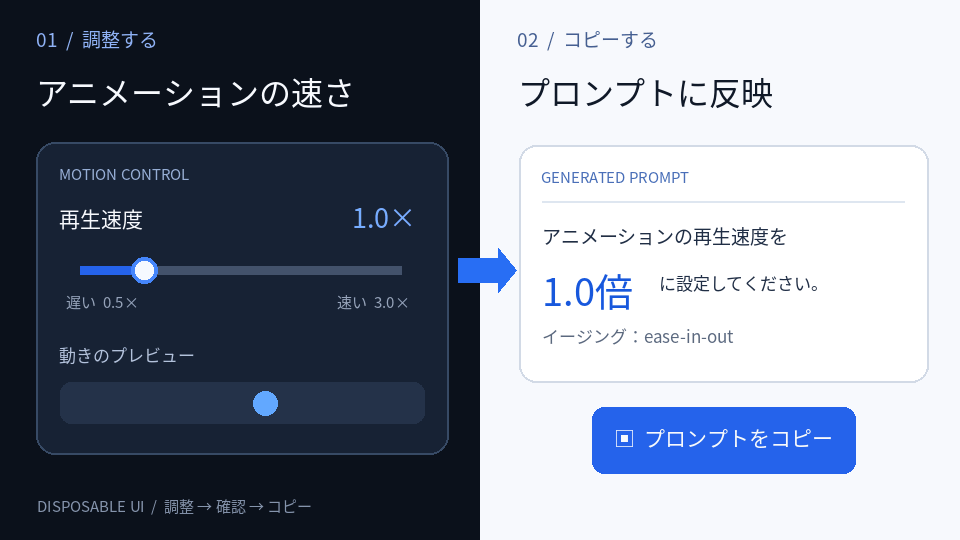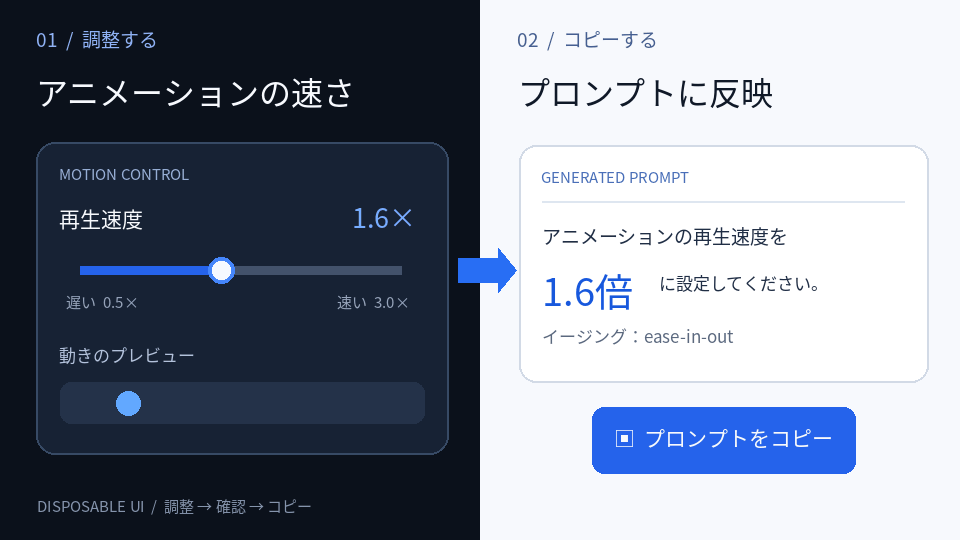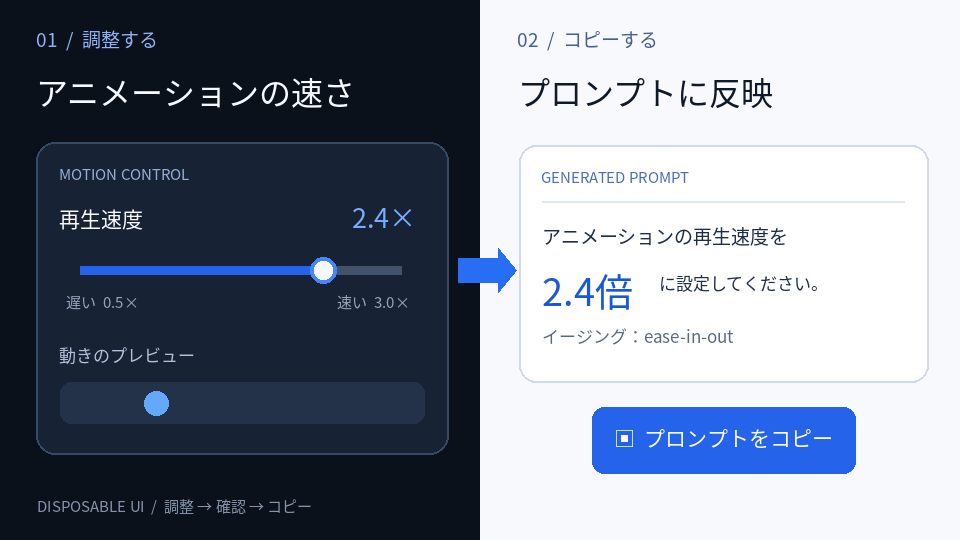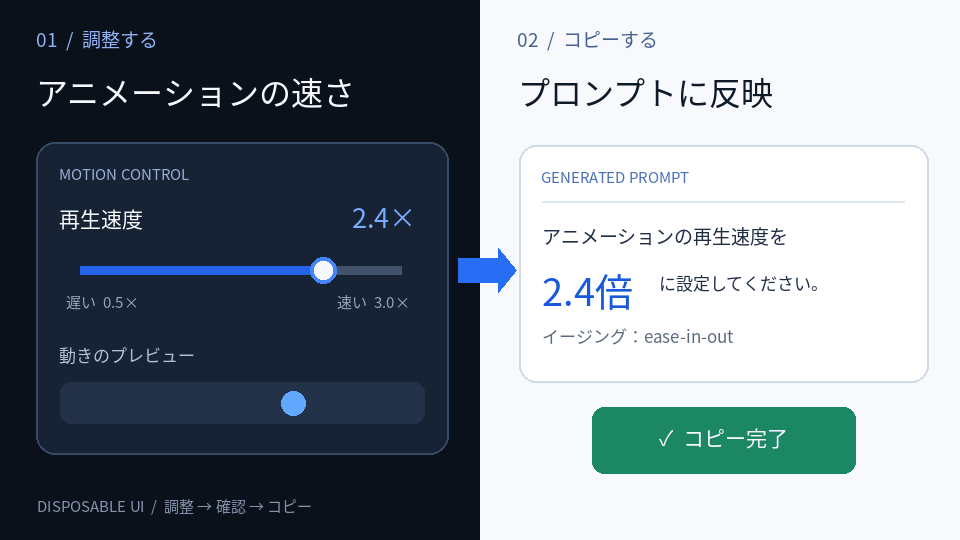
たとえば、アニメーションの速さを決めたいとき。 スライダー付きのHTMLを作ってもらい、実際に動かしながら調整します。 決まった値を「プロンプトとしてコピー」できるボタンまで付ければ、そのまま次の指示に使えます。
用が済んだら捨てる。 この「使い捨てUI(Disposable UI)」が、言葉では伝えにくい微調整を可能にします✨
③ 正本はMarkdown、HTMLは「見るときだけ」
保存して育てていく文書は、これまで通りMarkdownで管理します。 レビュー共有のときだけ、その中身をHTMLに変換して読みます。
こうすれば、Gitでの変更管理もしやすいままです。 HTMLファイルが増えすぎて散らかることもありません👍
Thariq氏が作ったHTMLの実例集(20種類)も公開されています。 イメージを掴むには、まずこちらを眺めてみるのがおすすめです。 → thariqs.github.io/html-effectiveness
ここから先は裏側の話です(読み飛ばし可)
ここからは、「なぜ1マスだけが変わったのか」を少し深掘りします。 使い方だけ知りたい方は、最後の「おわりに」まで飛ばしてもらって大丈夫です。
Markdownが選ばれていた2つの理由
Markdownは2004年、John Gruber氏が公開した記法です。 その本質は、HTMLのシンタックスシュガー(書きやすくするための簡略記法)です。
<h2>見出し</h2> と書く代わりに、## 見出し と書けば済む。 人間が思考を書き出すときの摩擦を、限りなく減らすために生まれました。
AIの世界でMarkdownが標準になったのには、もう一つ理由があります。 トークン(AIが文章を処理するときの単位)の節約です。
開発者のSimon Willison氏は、こう振り返っています。 GPT-4の時代はトークンの上限が約8,000と小さく、効率の良いMarkdownを使い続けてきた、と。
つまりMarkdownには、2つの理由がありました。 「人間が書きやすい」ことと、「トークンが少なくて済む」ことです。
変わったのは、後者の制約だけです。 前者は今も揺らいでいません。 だからこそ、人間がAIに指示を書くマスでは、Markdownが今も最適解なのです。
コストは消えていない、移動した
「AIがHTMLを一瞬で書けるようになったから、生成コストはゼロになった」。 そんな説明も見かけますが、これは正確ではありません。
HTMLはMarkdownより記述量が多くなります。 第三者の検証では、トークン数も生成時間も数倍になったという報告があります。
批判的な立場からは、次のような指摘も出ています。
- ソースのままでは読みにくい
- 安全でないHTMLが紛れ込むリスクがある
- トークンの消費が増える
- Gitで差分(変更箇所)を追いにくい
正確に言えば、コストは消えたのではなく、移動しました。 「人間が書くコスト」が下がった分、「人間が確かめるコスト」が新しいボトルネックになっています。 これが、③の「正本はMarkdown、HTMLは見るときだけ」をおすすめする理由です。
HTMLが効く条件、効かない条件
では、なぜ「読む」場面ではHTMLが強いのでしょうか。 鍵になるのが、ワーキングメモリ(情報を一時的に置いておく、脳の作業台)です。
心理学者ネルソン・コーワンの研究では、人が一度に保持できる情報は、およそ4つのまとまりとされています。 長い縦スクロールの文章では、上で読んだ内容を覚えたまま、下を読み進める必要があります。 作業台は、すぐにいっぱいになります。
一方、表や図で情報を空間に並べると、「覚えておく」役割を画面に任せられます。 目で行き来するだけで比較できるので、作業台に余裕が生まれるわけです。
ただし、HTMLなら何でも良いわけではありません。 教育心理学者ジョン・スウェラーの認知負荷理論では、理解に関係のない処理の負担を「外在的認知負荷」と呼びます。 意味のない装飾や動きは、まさにこの負担を増やします。
HTMLが効くのは、情報の構造そのものが多次元のときです。 比較、関係、時系列のように、もともと「面」で捉えるべき情報に限られます。 一直線に読めば済む短い説明なら、Markdownのほうが速く伝わることもあります。
正本とビュー——データ構造で見る2つの形式
最後に、データ構造の視点で整理します。
データベースには「テーブル」と「ビュー」という考え方があります。 テーブルはデータの正本で、ビューは目的に合わせて組み替えた「見せ方」です。
Markdownはテーブル、HTMLはビュー。 同じ中身を、保存するときはMarkdownで、読むときはHTMLで扱う。
こう捉えると、2つは対立するものではなく、役割分担だとわかります。 データ構造から道具を見直す視点は、Obsidianの記事でも詳しく書いています。
おわりに——問うべきは「誰が書き、誰が読むか」
「Markdownか、HTMLか」。 この問いは、どちらかが勝つまで終わりません。
しかし、抽象度を一段上げると、別の問いが見えてきます。 誰が書き、誰が読むのか。 データは、どちらへ流れるのか。
人間が書くなら、Markdown。 AIが書いて人間が読むなら、HTML。 AI同士なら、MarkdownやJSON。
起きたのは記法の世代交代ではなく、AIが書き手になったというShiftです。 そしてThariq氏が本当に守ろうとしたのは、HTMLではありません。 AIの仕事に、人間が関わり続けることでした。
流行り言葉で、記法の勝ち負けを決める必要はありません。 データの流れる向きを見極め、そこにふさわしいインターフェースを設計する。 それが、AIと対話しながら働く時代の本質です。
Design the Shift. ჱ̒⸝⸝•̀֊•́⸝⸝)
原文
HTML is the new markdown.
— Thariq (@trq212) May 8, 2026
- 公式ブログ版:Using Claude Code: The unreasonable effectiveness of HTML(claude.dev)
- 実例集:thariqs.github.io/html-effectiveness