6月に「主要AIモデル徹底比較」を書いてから、まだ3ヶ月半しか経っていません。
それなのに、当時「最新」として並べたモデルは、ほぼ全部が型落ちになりました。Claude は Opus 5.5、OpenAI は GPT-6、Google は Gemini 4 Argon。モデルだけでなく、性能を測るベンチマーク(AIの実力テスト)そのものまで世代交代しています。
正直、追いかけるだけで息切れしますよね。僕も表を作り直しながら「え、もう?」と何回か声が出ました笑
この記事では、6月から何がどれだけ変わったのかを数字で振り返ったうえで、用途ごとに「今ならどれを選ぶか」をまとめます。最後に、自分で並べ替えられる最新の比較表も用意しました。
まず結論 ── 今、用途別に選ぶなら?
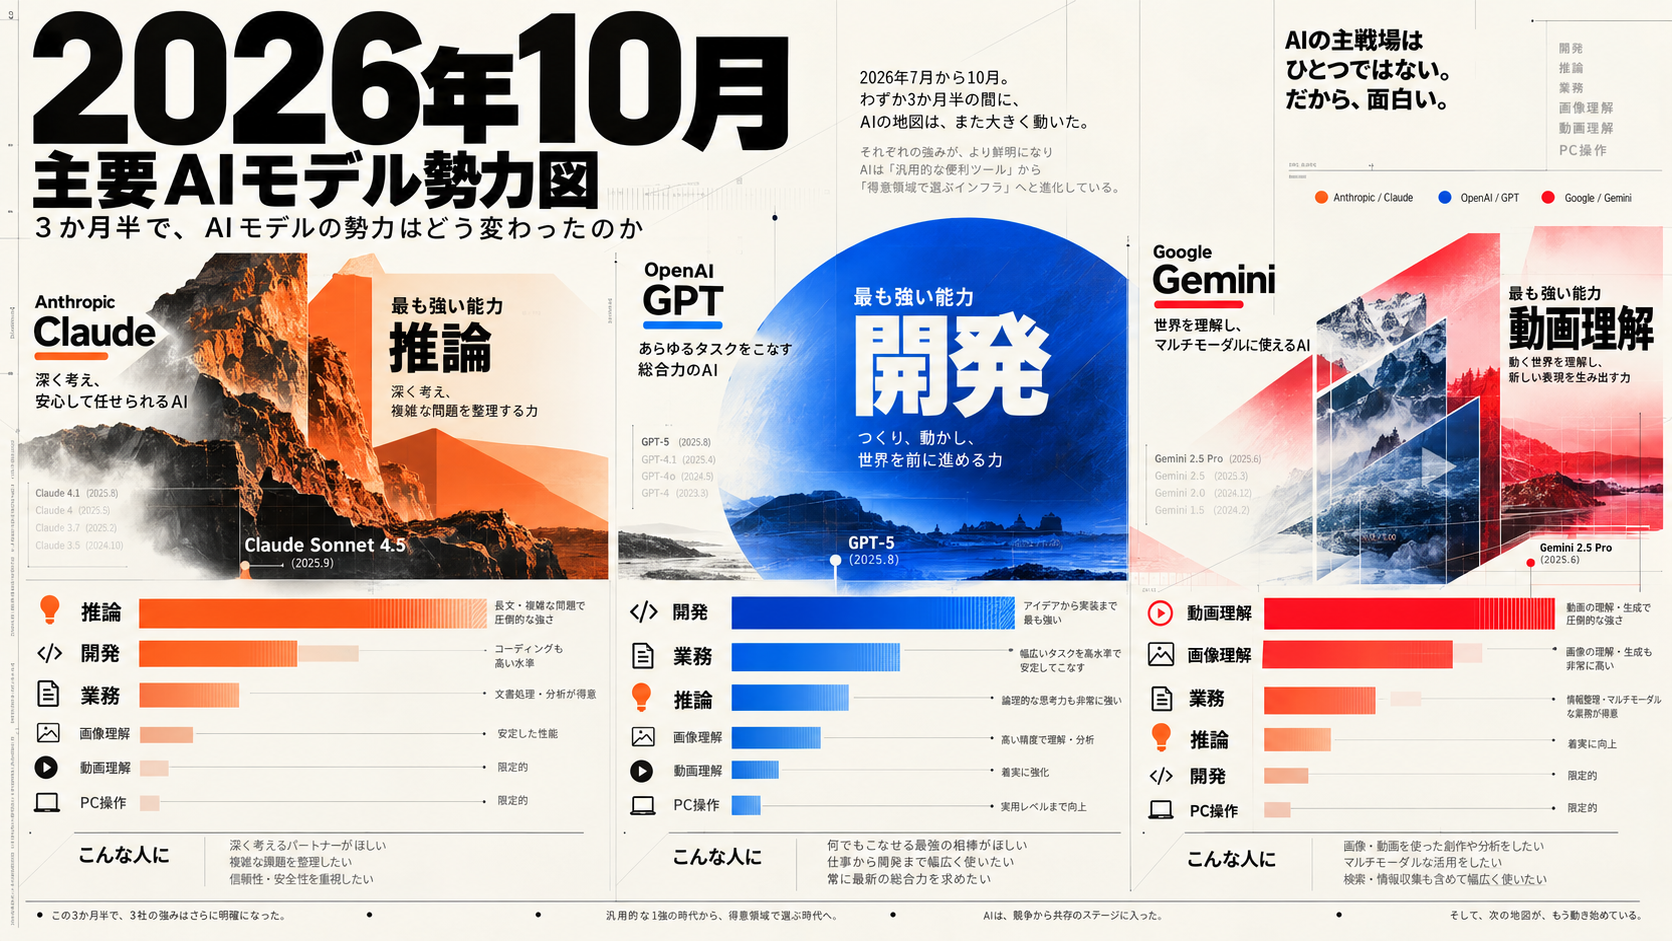
先に答えを置いておきます。詳しい理由はこのあと順番に説明します。
- コードを書かせたい → Claude Opus 5.5。ターミナル作業の新しい指標でトップ。数字だけなら Gemini 4 Argon も強いですが、まだ一部の人しか使えません。
- じっくり考えさせたい・壁打ちしたい → 数学や科学の難問なら GPT-6 Astra、幅広い専門知識を道具を使いながら調べる力なら Opus 5.5。
- 仕事を任せたい → 実務の総合力で Opus 5.5。業務の自動化や財務の分析では Gemini 4 Argon が頭ひとつ抜けています。
- 画像・動画を読ませたい → 図表なら Gemini 3.8 Flash、動画なら Gemini 4 Argon、PC操作なら Opus 5.5。
6月と同じく、全部の分野で1位のモデルはやっぱり存在しません。ただ、勢力図はかなり塗り替わりました。
6月から何が変わった? ── 3ヶ月半の大移動
モデルの世代交代
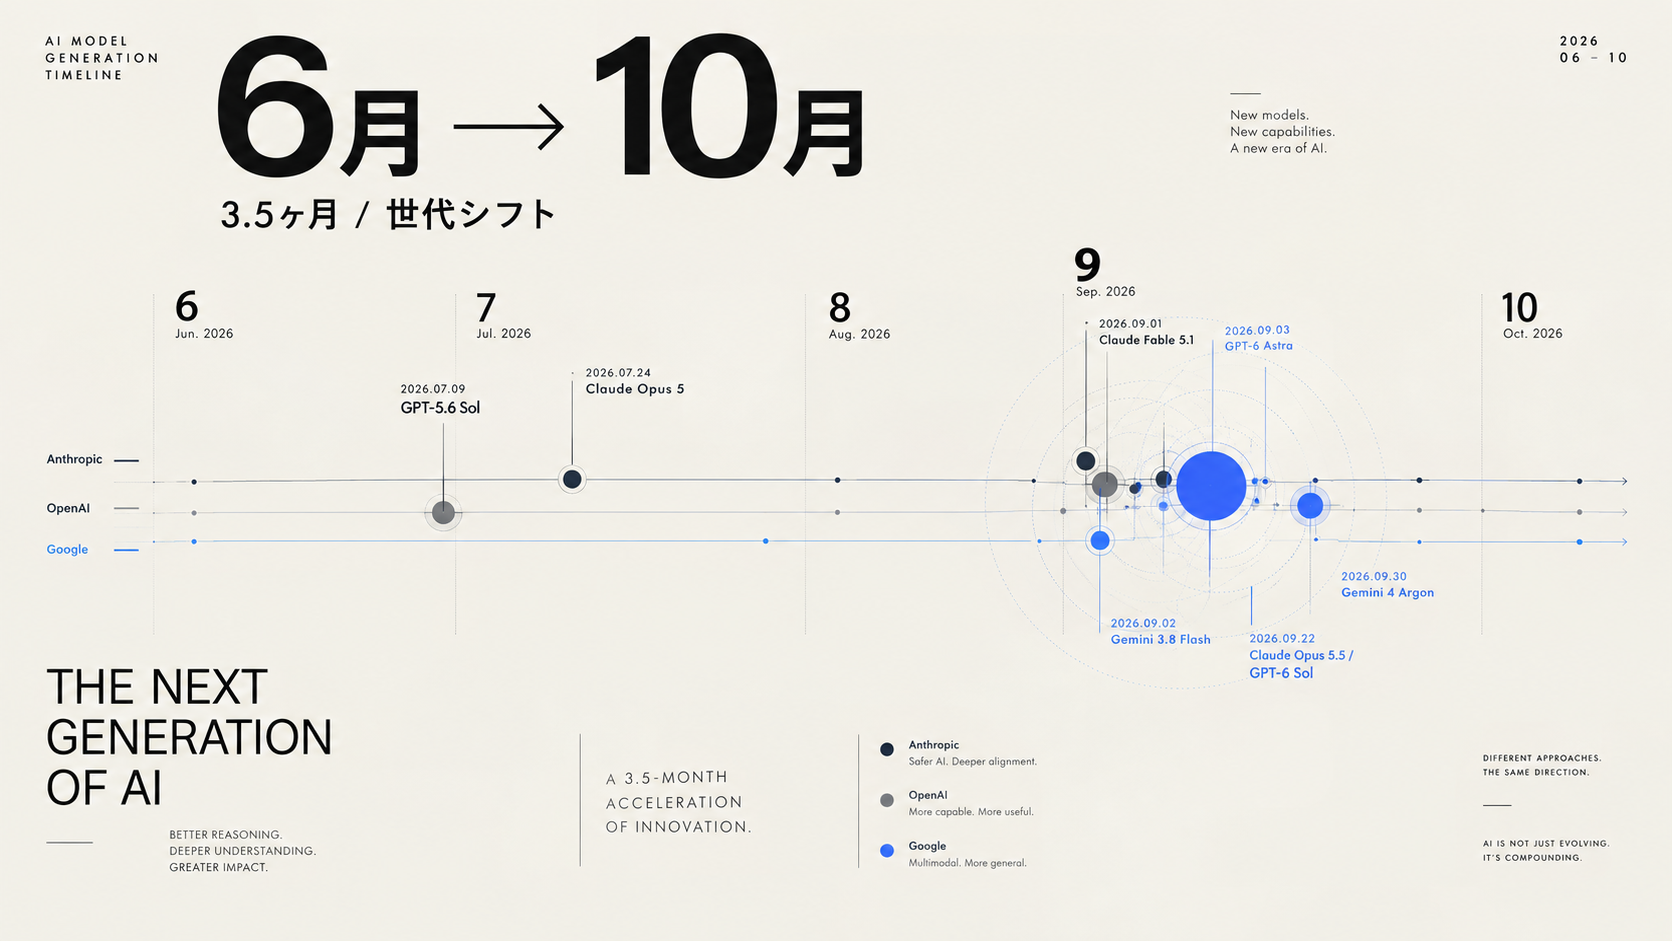
6月の記事で並べた各社のフラッグシップ(その時点での最上位モデル)は、Claude Fable 5 / Opus 4.8、GPT-5.5、Gemini 3.5 Flash でした。そこから、こう入れ替わっています。
時期 | 出来事 |
|---|---|
7/9 | OpenAI が GPT-5.6 Sol を公開 |
7/24 | Anthropic が Claude Opus 5 を公開 |
9/1 | Anthropic が Claude Fable 5.1 を公開 |
9/2 | Google が Gemini 3.8 Flash を公開 |
9/3 | OpenAI が GPT-6 Astra を公開 |
9/22 | Anthropic が Claude Opus 5.5、OpenAI が GPT-6 Sol を公開 |
9/30 | Google が Gemini 4 Argon を発表(現時点では限定公開) |
特に9月は、3社が1ヶ月のうちに次々と新モデルを出すという、なかなかの渋滞っぷりでした。
数字で見る「どれだけ賢くなったか」
6月と今を、同じ物差し(同じベンチマーク)で比べられる項目だけ抜き出してみます。
- FrontierMath Tier 4(研究者レベルの数学の超難問)── GPTシリーズは 35.4% → 97.6%(GPT-5.5 → GPT-6 Astra)。6月時点の最高だった Fable 5 の87.8%も、ついに超えました。
- SWE-bench Pro(本番に近い難しいバグ修正)── Claude は 69.2% → 79.2%(Opus 4.8 → Opus 5)。2ヶ月で約10ポイント。
- Humanity's Last Exam・ツールあり(人類最後の試験)── 6月の最高 64.5%(Fable 5)→ 67.7%(Opus 5.5)。
- AutomationBench(ビジネス業務の自動化)── 6月の最高 17.4%(Fable 5)→ 51.3%(Gemini 4 Argon)。約3倍です‼️
- Finance Agent v2(財務分析のエージェント作業)── 6月の最高 57.9%(Gemini 3.5 Flash)→ 65.4%(Gemini 4 Argon)。
いちばん伸びが大きいのは、「答えを当てる力」よりも「仕事を段取りよく最後までやり切る力」のほうです。AIが「賢い相談相手」から「任せられる働き手」に寄ってきている、というのが数字から見える一番の変化だと僕は感じています。
ベンチマーク自体も世代交代した
もうひとつ大きいのが、物差しのほうが追いつかれてしまったことです。
たとえば6月に紹介した Terminal-Bench(2.1)は、トップモデルが軒並み90%前後に並び、差がつかなくなりました。満点近くまで解かれてしまったテストは、もう実力の差を測れません。
そこで、より難しい新しいテストに切り替わっています。
- Terminal-Bench 2.1 → Terminal-Bench 4.0(トップでも66.4%)
- OSWorld-Verified → OSWorld 2.0
- ARC-AGI-2 → ARC-AGI-3
- GDPval-AA → GDPval-AA v2.1
- 新顔として DeepSWE、AutomationBench など
なので、6月の記事で「ここを見てください」と紹介したベンチマークの一部は、最新モデルではもう測られていません。このあと紹介する用途別のベンチマークも、新しい世代に合わせて入れ替えています。
「ベンチマーク」って何?(おさらい)
初めて読む方のために、ざっくりおさらいです。
ベンチマークは、AIの実力をいろんな角度から数字にしたもの。学校の模試と同じで、「プログラミングの点数」「推論の点数」「画像を読む点数」のように分野ごとのテストがあります。基本は数字が高いほど優秀です。
ひとつだけ注意点があります。これらの数字は、基本的に各社が自分で発表した値です。同じモデルでも、測った会社によって数ポイント違うことがあります。比較表では、原則として「そのモデル自身の会社が出した値」を採用しています。
「総合1位」はまだ存在しない
ここは6月の記事と同じ結論です。
たとえば Gemini 4 Argon は、Google が発表した19項目のうち13項目で首位でした。これだけ見ると「最強では?」と思いますよね。でも、ターミナル作業の新指標 Terminal-Bench 4.0 では、Opus 5.5 の66.4%に対して Argon は57.4%。ここではっきり差がついています。
逆に Opus 5.5 も、業務の自動化(AutomationBench)では Argon に10ポイント以上離されています。
全部の分野で1位の「最強モデル」は、今回も存在しませんでした。正しい問いは、やっぱり「自分がやりたいことに、一番合うのはどれ?」です。
ここからは、よくある使い方を4つに分けて、それぞれ「どのベンチマークを見ればいいか」と「今の上位モデル」を紹介します。
用途1:コードを書かせたい(開発者向け)
6月から、見るべき指標が少し変わりました。
- DeepSWE v1.1 ── 長い時間をかけて、大きなソフトウェアの改修をやり切れるかを測る新しいテスト。1位は Gemini 4 Argon(77.9%)、続いて Opus 5.5(74.2%)、GPT-6 Astra(74.1%)。上位はかなりの接戦です。
- SWE-bench Pro ── 複数ファイルにまたがる、本番に近い複雑な修正。6月から引き続き使える指標です。最新世代はまだ公表が少ないものの、Opus 5 が79.2%と、6月時点の Opus 4.8(69.2%)から大きく伸びています。
- Terminal-Bench 4.0 ── ターミナル(黒い画面にコマンドを打つ、開発者の操作画面)での作業力。旧版が飽和したので作り直された新版です。Opus 5.5 が66.4%で首位、GPT-6 Astra(57.7%)と Gemini 4 Argon(57.4%)が続きます。
「今すぐ実務で使えるモデル」という条件をつけるなら、僕は Opus 5.5 を推します。Argon は数字こそ強いですが、まだ限定公開なので、ほとんどの人はまだ試せません。
用途2:人生相談・壁打ち相手
考えごとの相手にしたい、悩みを整理したい、複雑なテーマを一緒に深掘りしたい。そういう「対話の深さ」を求める人は、推論力のベンチマークを見ます。
- GPQA Diamond ── 大学院レベルの科学の難問。GPT-6 Astra が96.0%で首位です。ただ、上位モデルはほぼ全部92〜96%の範囲に収まっていて、そろそろ差がつかなくなってきた指標でもあります。
- Humanity's Last Exam(ツールあり) ── あらゆる分野の専門家が作った超難問を、検索などの道具を使いながら解くテスト。Opus 5.5 が67.7%で首位、Fable 5.1(65.6%)が続きます。
- ARC-AGI-3 ── 初めて見るルールをその場で見抜くパズルの新版。GPT-6 Astra が99.9%という数字を出していますが、これは状態を保持する専用の実行環境で測った値です。普通の使い方では17〜63%程度と報告されているので、この数字はそのまま受け取らないほうがいいです💡
数学や科学のガチガチの難問なら GPT-6 Astra、幅広い分野を調べながら深く考える相手なら Opus 5.5。このあたりが今の答えだと思います。
用途3:仕事を任せたい(ビジネス戦略・実務サポート)
6月から一番大きく動いたのが、この分野です。
- GDPval-AA v2.1 ── いろんな職業の実務タスクを、人間の専門家と比べてどこまでこなせるか。採点基準が新しくなった版で、Opus 5.5 が1846で首位、Fable 5.1(1735)が続きます。
- AutomationBench ── 複数の業務ツールをまたいで、仕事の流れを自動でこなせるか。Gemini 4 Argon が51.3%で首位、GPT-6 Astra(41.4%)、Opus 5.5(40.0%)が続きます。6月の最高は17.4%だったので、ここは本当に別物になりました。
- Finance Agent v2 ── 財務の分析や意思決定を、エージェント(自分で考えて作業を進める働き手)としてこなせるか。Gemini 4 Argon が65.4%で首位、2位も Gemini 3.8 Flash(61.4%)。この分野は Gemini が強いです。
文章や資料を含めた実務の総合力なら Opus 5.5、業務フローの自動化や数字まわりなら Gemini 系。得意分野がはっきり分かれてきた印象です。
用途4:画像を読ませたい(資料・図表・動画の理解)
ここは「画像を作る」ではなく、「画像を読ませて理解させる」用途の話です。
- CharXiv Reasoning ── 複雑なグラフやチャートから情報を読み取って考える力。Gemini 3.8 Flash が86.2%で首位、GPT-5.6 Sol(85.8%)が僅差で続きます。
- LVBench ── 長い動画の中身を理解する力。今回から新しく入れた指標です。Gemini 4 Argon が91.7%で首位、Gemini 3.8 Flash(87.8%)と GPT-6 Astra(87.5%)が続きます。
- OSWorld 2.0 ── AIが実際のパソコン画面を見て、マウスやキーボードで作業をこなせるか。Opus 5.5 が81.8%で首位です。ただし、このテストは会社ごとに測定条件が違い、Anthropic の値は高めに出る傾向があります。順位は参考程度に見てください。
図表や動画を読ませるなら Gemini、PCを操作させるなら Claude。ざっくりこう覚えておけば大丈夫です👍
数字に出ない変化 ── 僕が使って感じたこと
ここからは、ベンチマークには出てこない、僕自身の体感の話です。
Claude アプリが、とにかく軽くなった
最近、Claude アプリの起動や返答の出だしが明らかに速くなりました。あくまで体感ですが、待たされる感じがかなり減っています。
モデル自体の処理速度が上がったというより、アプリ側の最適化が効いている印象です。毎日何十回も開くものなので、この「数秒の差」が、使い心地としては一番効いています。
Gemini Notebook ──「調べる」と「書く」がつながった
Google 側で大きかったのが、Gemini Notebook です。
- 7/16:NotebookLM(資料を読み込ませて質問できる Google のツール)が「Gemini Notebook」に改名。Gemini アプリと完全に同期するようになりました。会話の途中で追加したソースが、自動でノートブックに入ります。
- 9/24:Google ドキュメントから、Gemini Notebook のノートブックを参照元として読み込めるようになりました。ノートブックに集めたリサーチ結果を、ドキュメントで下書きしながらそのまま使えます。
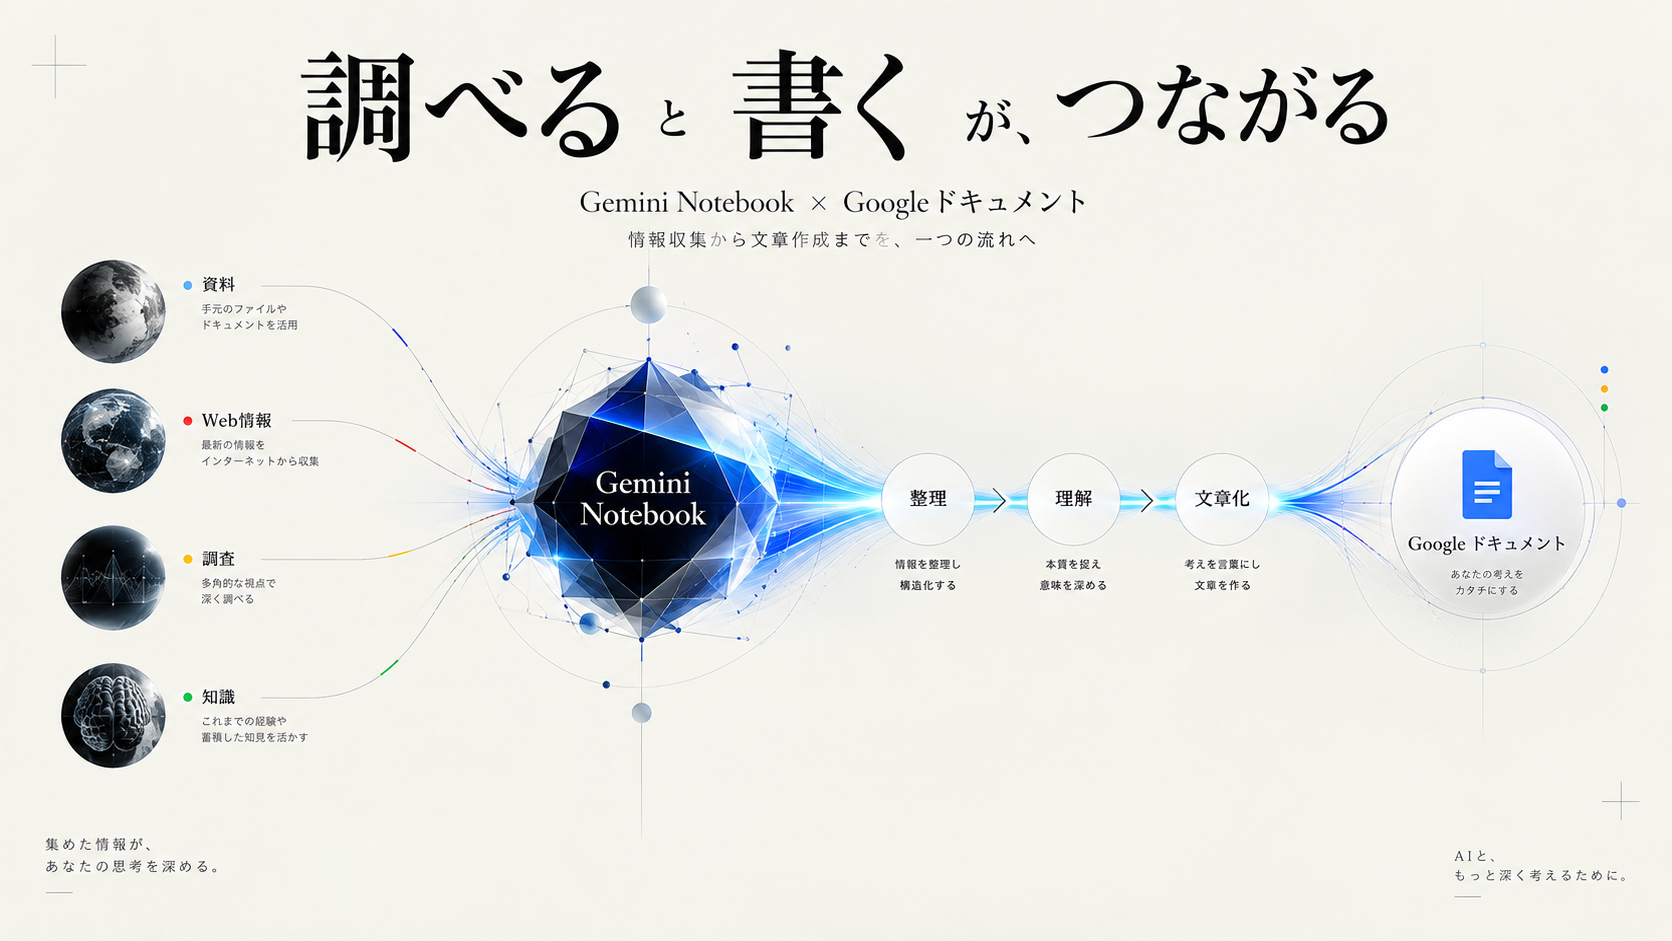
これで、「調べる(Notebook)」と「書く(ドキュメント)」が地続きになりました。プロジェクトごとに資料を整理しておいて、それを材料に文章を書く。この流れが Google の中で完結するようになったのは大きいです。
それと、これは公式発表ではなく僕の体感なのですが、ちょうど同じ9/24ごろから、会話の途中でもナレッジ(ノートブックに入れた資料)を読み返してくれるようになりました。
- 以前:2往復目以降のやり取りでは、元の資料を参照できませんでした。読み返せるのは、会話の最初に作られた要約だけです。
- 最近:2往復目以降でも「ナレッジの◯◯ファイルを読み返してみて」と頼めば、元の資料をもう一度参照してくれます。
以前は、話が進むほど要約に載っていない細かい部分が抜け落ちて、「さっきの資料のあの部分、もう一回見て」と頼んでも拾ってもらえませんでした。今は、長い資料を何往復もしながら深掘りできます。地味な変化ですが、個人的にはかなり大きいです💡
Gemini Spark ── 24時間働くアシスタントが日本でも使えるように
Gemini Spark は、ユーザーの指示のもとで24時間動き続けて、代わりに作業を進めてくれる個人用のAIエージェントです。
発表自体は5月の Google I/O でしたが、そのときに使えたのは米国の一部ユーザーだけでした。そこから、
- 6/30:Mac アプリで、定期実行(Schedules)やスキル(Skills)に対応
- 7/14:日本を含む多くの国の Google AI Ultra 加入者に解禁
- 7/16:米国の Pro プランにも解禁
と、6月以降に一気に「普通に使えるもの」になりました。寝ている間も仕事が進む、という感覚が少しずつ現実になってきています。
Gemini 4 Argon ── 速さと強さの両立、その先へ
最後に、Gemini 4 Argon です。
普段使っている Gemini は、体感でとにかく返答が速いのが魅力です。そこに来て Argon は、ベンチマークで各社の最上位モデルと並ぶか、上回る数字を出してきました。DeepSWE、AutomationBench、Finance Agent、LVBench と、首位を取った項目の幅も広いです。
ここからは完全に僕の予想です。Google は今のところ「Gemini 4 の Pro 版」を発表していません。ただ、これまでの流れを見ると、もし Argon の上位版が出てくるなら、とんでもないモンスターになるのではと期待しています ჱ̒⸝⸝•̀֊•́⸝⸝)
なお、Argon は現時点で限定公開です。サイバー防御のパートナーなど一部しか使えず、Google AI Ultra 加入者や有料APIの利用者へ順次広げていく予定とされています。
あとは、自分で確かめてください
ここまで用途ごとに紹介してきましたが、文章だけだとピンと来ないですよね。今回も、実際に触って並べ替えられる比較表を2種類用意しました。
ベンチマーク表(DeepSeek・Kimi入り/モデル選択つき・2026.10)
【画像挿入:比較表のサムネイル】
使い方は6月版と同じです。ベンチマークの行をクリックすると、スコアの高い順にモデルが並び替わり、1位から順にバッジが付きます。「シンプル / フル」「開発者向け / 一般向け」のタブで、表示するベンチマークを絞り込むこともできます。
今回のポイントは2つです。
- 「2026.06時点」タグのついたモデル(Fable 5・Opus 4.8・GPT-5.5・Gemini 3.5 Flash)は、6月の記事を書いた時点のフラッグシップです。SWE-bench Pro や Humanity's Last Exam の行で並べ替えると、6月からの進化が一目で分かります。
- DeepSeek・Kimi 入りの表では、モデル選択パネルで比べたいモデルだけを表示できます。オープンモデル(誰でも中身を使えるモデル)も最新世代に更新しました。
6月のモデルは新しいベンチマークで測られていないので、「—(未公表)」が多くなっています。そこは「測られていない」だけで、「0点」ではないので注意してください。
おわりに
3ヶ月半で、モデルも物差しも入れ替わりました。正直、この記事も来年の今ごろには「懐かしい」と言われていると思います笑
それでも、選び方の軸は変わりません。ベンチマークは、自分の用途に合うモデルを選ぶための地図です。地図そのものは更新され続けますが、「自分は何をしたいのか」から逆算して数字を見る、という読み方さえ持っていれば、どれだけ世代交代が起きても迷わずに済みます。
地図が新しくなるたびに、また一緒に読み直しましょう。